2026 年 7 月 26 日前后,我准备做 RedSkill。那时最容易被“这里好像没人做”带着走。空白可能是机会,也可能只是没人需要;投稿很多也不等于需求旺盛,因为同一作者可以批量发布,未上榜项目又没有公开使用数据。
我先把几个误判放到旁边。搜索结果不是平台全量,投稿数量不能直接代替用户需求,同类少也不能自动说明更值得做。数据能提供的是一张供给地图,产品判断还得继续往后走。
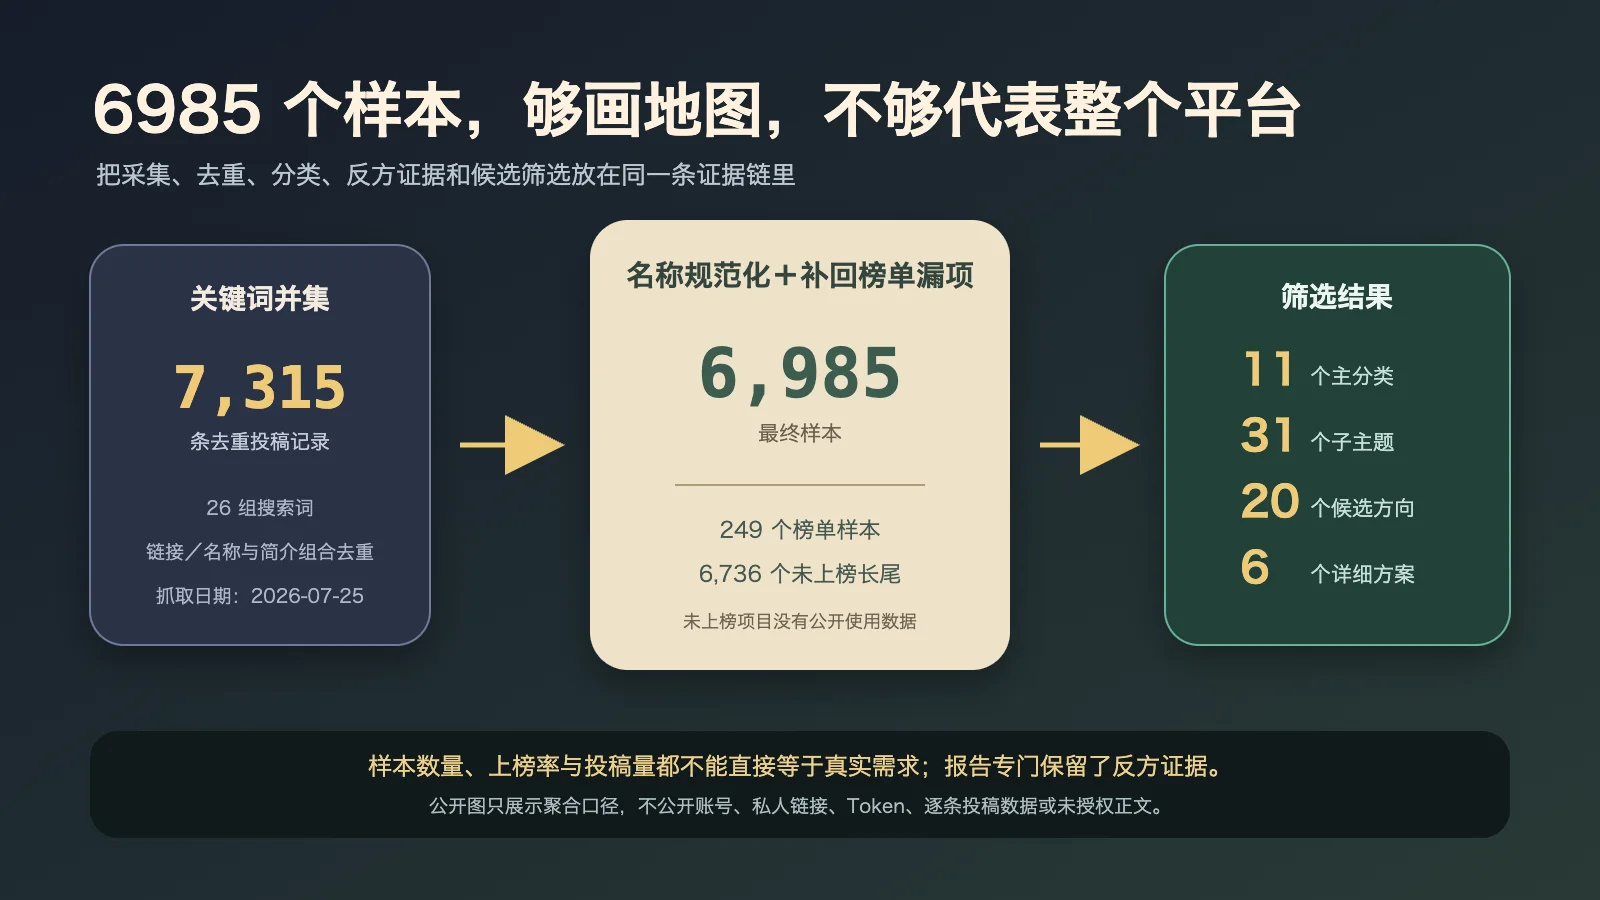
本轮先用 26 组关键词扩展搜索,采集阶段得到 7315 条去重投稿记录;再按规范化 Skill 名称合并同名项目,并补回榜单漏检项,得到 6985 个样本。工作簿把 249 个榜单样本和 6736 个未上榜长尾分开,归入 11 个主分类与 31 个子主题,同时保留来源、置信度和覆盖限制。RedSkill 样本从采集到候选筛选的证据链
数据里的多和少都需要第二层解释。内容与视觉类样本多,说明拥挤;通用效率类未上榜项目多,却没有公开使用数据,不能因此判断成蓝海。头部作者批量投稿也会放大供给量,所以报告专门把反方证据放进每个候选方向。
工作簿包含 8 个工作表,全量明细范围到第 6986 行,首行为表头;结构化数据中的 total 和 items 长度都为 6985,ranked 为 249,unranked 为 6736。研究先列 20 个候选,再量化比较 10 个,最后只把 6 个写成详细方案,没有同时开发六个。现在看平台数据,我会先写口径和不能说什么,再看排名。样本越多,越要小心把看见很多误写成看见全部。